Google только что устроила новейшим ИИ-моделям жесткий тест на программирование — вот как они справились
ОС AndroidAndroid Bench 2.0 от Google проверяет, насколько эффективно ведущие ИИ-модели справляются со сложными задачами по разработке для Android, на решение которых у инженеров-людей могут уходить дни.
Что нужно знать
- Google выпустила Android Bench 2.0 для тестирования ИИ-моделей на сложных задачах по разработке Android-приложений, которые могут занимать несколько дней.
- Новый бенчмарк включает такие задачи, как обновление зависимостей, добавление масштабных функций и создание приложений для Android с нуля.
- GPT-6 Astra в настоящее время лидирует в новом бенчмарке Google с показателем успешного выполнения в 28%, в то время как Gemini 3.8 Flash набрала всего 8%.
Компания Google анонсировала Android Bench 2.0 — обновленную версию своего бенчмарка для оценки того, насколько эффективно большие языковые модели (LLM) и ИИ-агенты справляются со сложными задачами разработки под Android.
Ранее в этом году Google представила первую версию Android Bench для измерения производительности ИИ-моделей в реальных условиях разработки под Android. Теперь компания обновила бенчмарк до версии Android Bench 2.0, которая создана для оценки моделей и агентов при решении более сложных задач, в большей степени отражающих реальную разработку программного обеспечения.
Одним из главных нововведений стали так называемые задачи с долгосрочным горизонтом планирования (LHT). Это значительно более сложная проектная работа, на выполнение которой у инженера-человека могут уйти дни или даже неделя.
В Google отмечают, что первая версия Android Bench, как и многие другие ранние бенчмарки кодирования для ИИ, была сосредоточена главным образом на небольших итеративных изменениях. Android Bench 2.0 призвана поднять эту планку благодаря таким задачам, как обновление зависимостей, добавление крупных новых функций и даже создание Android-приложений с нуля.
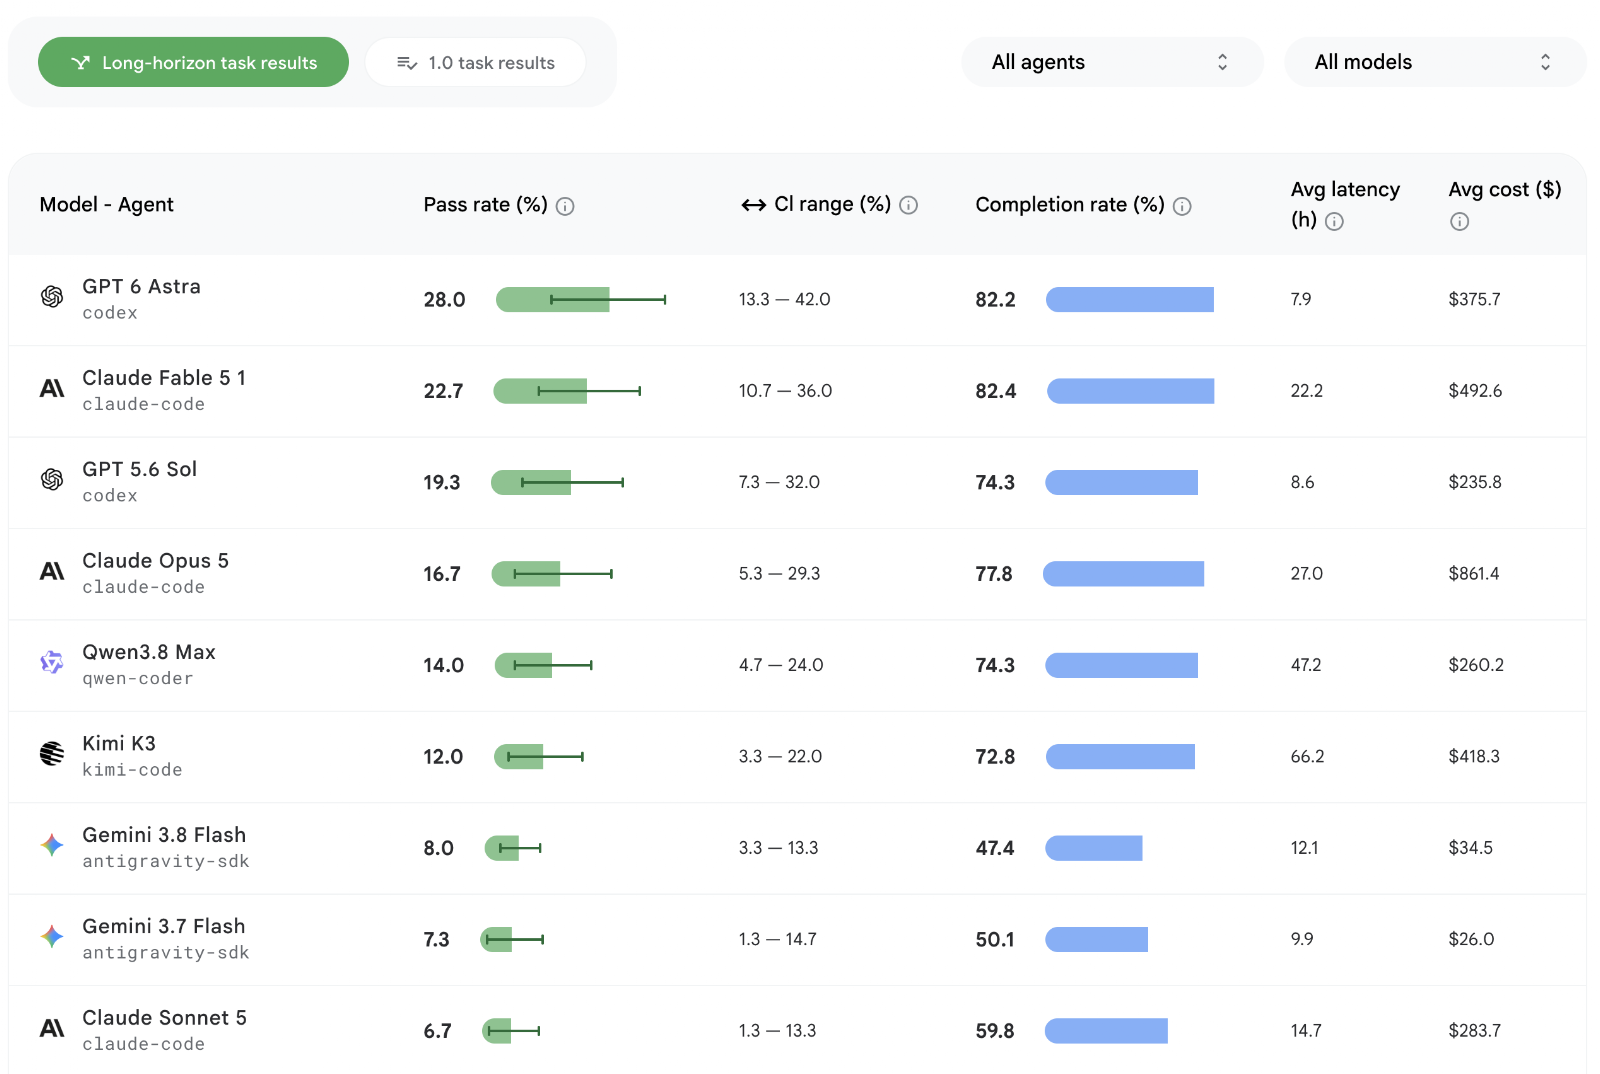
В Android Bench 2.0 компания Google изменила подход к оценке моделей. Вместо того чтобы полагаться исключительно на бинарную систему «успех-неудача», в Android Bench 2.0 используется «непрерывная система баллов». По заявлению компании, это дает более «показательное представление» об эффективности модели, даже если она не смогла полностью справиться с задачей.
Google уже протестировала несколько новейших ИИ-моделей с использованием нового бенчмарка, включая Gemini 3.8 Flash, GPT-6 Astra, Claude Fable 5.1, GPT-5.6 Sol и Claude Opus 5. Согласно результатам, GPT-6 Astra в настоящее время занимает верхнюю строчку бенчмарка с показателем успешных выполнений в 28%. Тем временем Gemini 3.8 Flash набрала всего 8%.
В Google считают, что тестирование моделей на наборе данных LHT позволит лучше понять их сильные и слабые стороны, а также предоставит разработчикам более практические рекомендации о том, какие модели лучше подходят для тех или иных задач по разработке под Android.
Обновленная таблица лидеров Android Bench 2.0 уже доступна, и в Google заявляют, что планируют со временем расширять ее, добавляя новые модели и результаты.