Google теперь будет показывать, какие ИИ-модели лучше всего создают приложения для Android
Приложения и софтКонечно, Gemini на вершине.
Что нужно знать
- Google анонсировала Android Bench — инструмент для оценки эффективности ИИ-моделей при решении реальных задач разработки под Android.
- Gemini 3.1 Pro возглавила таблицу лидеров Android Bench, обойдя модели Claude Opus и GPT Codex.
- Тест оценивает модели ИИ на основе реальных задач по написанию кода для Android различного уровня сложности.
Речь уже не только о генерации картинок и видео по текстовому описанию. Теперь с помощью простой подсказки можно создавать полноценные работающие приложения. Тем не менее, не каждая модель ИИ, заявляющая о способности создавать приложения, справляется с этим одинаково хорошо, и Google намерена установить стандарт, показывающий, какие модели работают эффективнее всего.
Концепция вайб-кодинга быстро стала одним из главных трендов 2026 года: всё больше людей пытаются создавать собственные приложения и сервисы с помощью ИИ. Компания Nothing недавно продемонстрировала инструмент, позволяющий пользователям создавать простые приложения с помощью промптов.
Однако любой, кто сталкивался с разработкой под Android, знает, что для этого недостаточно просто написать пару запросов. В Google хотят выделить те ИИ-модели, которые действительно способны справляться с подобными задачами.
Для этого компания Google представила новый бенчмарк под названием Android Bench. Он создан специально для оценки больших языковых моделей в контексте разработки приложений для Android. Инструмент замеряет эффективность моделей на реальных задачах, предлагая им набор испытаний разной степени сложности.
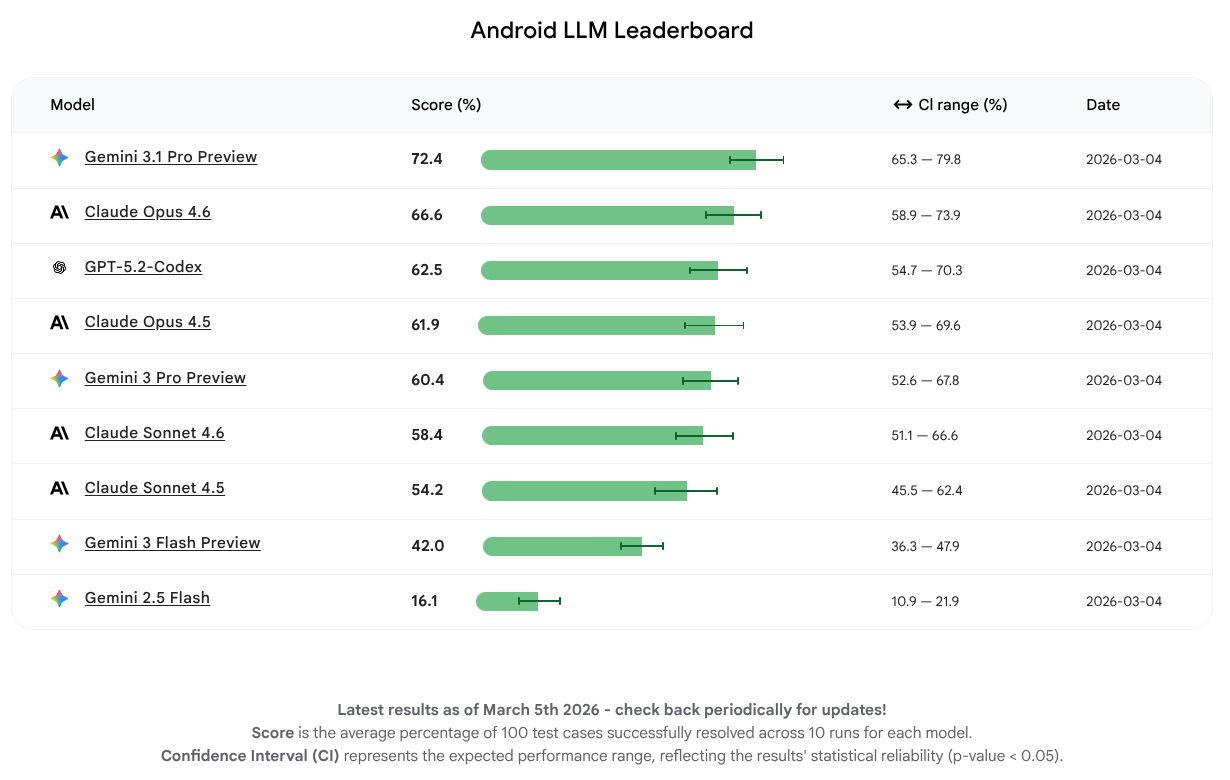
По данным Google, протестированные модели успешно справились с долей задач от 16% до 72%. Лучший результат показала предварительная версия Google Gemini 3.1 Pro, набравшая 72,2%. Модель Claude Opus 4.6 расположилась следом с результатом 66,6%, в то время как GPT 5.2 Codex заняла третье место с показателем 62,5%.
Результаты показывают, что ИИ-модели уже весьма неплохо помогают в разработке под Android. В Google отмечают, что главная цель Android Bench заключается в том, чтобы «сократить разрыв между концептом и качественным кодом». В долгосрочной перспективе компания рассчитывает, что пользователи смогут создавать Android-приложения, просто описывая свои пожелания.
Чтобы обеспечить максимальную прозрачность, Google также выложила методологию, набор данных и инструменты тестирования в открытый доступ на GitHub.
Мнение Android Central
Возможно, обычному пользователю это покажется маловажным, но появление бенчмарка для языковых моделей, ориентированного именно на разработку под Android — это отличная новость для девелоперского сообщества. Это упрощает поиск действительно полезных для создания приложений моделей, избавляя от необходимости гадать на кофейной гуще или тестировать массу инструментов в поиске рабочего варианта.